Blog

ブログ

EC-CUBE 4.4 の MCP サーバを AI クライアントから使う

先にまとめ:

  • 4.4 には MCP サーバがコア同梱。読み取り専用ツール11個、既定 OFF
  • 本体だけではツールの出力が空になる。公式 API プラグイン ec-cube/api44 が必須(認証と公開範囲の定義を担当している)
  • Api44 を入れると管理画面から MCP 用のアクセストークンを発行できる。
  • トークンのスコープでMCPの行動範囲を指定できる。
  • bin/consoleから人力で叩くこともできる(ツールがそのままコマンドになっている)、AI クライアントからは HTTP + トークン
  • 本番で有効にするなら TRUSTED_HOSTS の設定が必須

検証は 2026-09-08 時点の 4.4 ブランチ(efa640d)と eccube-api4 の 4.4 ブランチ、同梱の docker-compose 構成(PHP 8.2 / Apache / PostgreSQL 18)で行いました。どちらも開発中なので、正式版で挙動が変わる可能性があります。

この記事はClaude Opus 5が執筆しています。

EC-CUBE MCP はどんなものか

 MCP(Model Context Protocol)は、AI クライアントに外部データやツールを渡すための標準プロトコルです(公式サイト、Anthropic の発表)。

EC-CUBE 4.4 はこのサーバ側をコアに実装しました。4.4 全体の位置づけとリリース時期は公式ロードマップ #6762 にあります(正式版は 2026年10月下旬予定)。

用意されているツールは11個で、すべて読み取り専用です。書き込み系のツールはありません。必要なスコープはツールごとに決まっていて、対応は src/Eccube/Service/Mcp/McpToolScopeMap.php の1箇所に定義されています。

ツール 内容 必要スコープ
search_products / get_product / get_product_stock 商品検索・商品詳細・在庫 mcp:product:read
search_orders / get_order / get_shipping 受注検索・受注詳細・配送 mcp:order:read
search_customers / get_customer / get_customer_orders 会員検索・会員詳細・購入履歴 mcp:customer:read
list_plugins / get_plugin プラグイン一覧・詳細 mcp:plugin:read

有効化は既定 OFF(BaseInfo の mcp_enabled が false)で、店舗設定(/admin/setting/shop)のトグルから明示的に行います。無効の間は /admin/mcp が 404 を返し、エンドポイントの存在自体を明かしません。

環境を用意する

Docker Compose での環境構築は公式ドキュメントのとおりなので省略します(Docker Compose を使用したインストール、システム要件)。今回は 4.4 ブランチを clone して PostgreSQL 18 の構成で立てました。

データが無いと MCP のツールを試せないので、ダミーデータを生成します。

bin/console eccube:fixtures:generate \
  --products=50 --orders=30 --customers=30 --without-image

商品52件・受注900件・会員30件が入りました。商品名は文学作品のテキストから切り出されるので意味不明な文字列になりますが、件数と構造の確認には十分です。

環境構築で3点つまずいたので記録しておきます。

  • macOS では GID を渡すと起動しない(groupmod: GID '20' already exists)。UID だけ渡す
  • Docker でも .env は必要。 無いと DB 設定が届かず、エラーにならずに SQLite へフォールバックします(doctrine.yaml の既定 driver が pdo_sqlite)。症状は「CLI は動くのに Web だけ 500」
  • docker compose exec を root で叩くと Web が 500 になる。 監査ログが root 所有で作られ、Apache が追記できなくなります。-u www-data を付ける(復旧は chown -R www-data:www-data var vendor)

ツールは bin/console からも叩ける

MCP クライアントを用意する前に、CLI で全ツールを試せます。11個のツールが 1ツール1コマンドとして生えています。

$ bin/console list eccube
...
  eccube:cli:get_customer            EC-CUBE の会員 ID から会員詳細 (氏名・連絡先・住所など) を取得する。 読み取り専用。 必要 scope: mcp:customer:read。 allow_list に PII が含まれる。
  eccube:cli:get_customer_orders     EC-CUBE の指定会員の購入履歴 (注文一覧) を取得する。 ...
  eccube:cli:get_order               ...
  eccube:cli:search_products         EC-CUBE の商品をキーワード / カテゴリ / 公開ステータス / 在庫数で検索し、商品一覧を返す。 ...

オプションと説明文も MCP の入力スキーマから自動生成されます。

$ bin/console eccube:cli:search_products --help

Options:
      --keyword=KEYWORD        ID または商品名 / 商品コードの部分一致 (任意)
      --categoryId=CATEGORYID  カテゴリ ID。 子カテゴリも対象 (任意)
      --statusIds=STATUSIDS    商品ステータス ID の配列。 1=公開、 2=非公開、 3=廃止 (任意、 既定 [1])
      --stockMin=STOCKMIN      在庫がこの値以上の表示規格を持つ商品のみ (任意)
      --stockMax=STOCKMAX      在庫がこの値以下の表示規格を持つ商品のみ (任意)
      --limit=LIMIT            取得件数。 1〜200 (既定 10)
      --offset=OFFSET          スキップ件数 (既定 0)

実装のコメントには、これが用意された理由が書かれています。

MCP サーバでできる操作を bin/console からも同じように行うための実行口(playwright-mcp に対する playwright-cli の位置づけ)。コンソール AI クライアント (Claude Code 等) が、コンテキストを食う MCP サーバ接続なしに同じツールを叩ける。

検証する側にとっても、MCP クライアントを準備せずに全ツールの挙動を確認できるので早いです。この経路は手元で人が確認するためのもので、後述のトークンは要りません(スコープ検査を通らないため、11個すべて叩けます)。

ただし、本体だけの状態で叩くと出力が空になります。

$ bin/console eccube:cli:search_products --limit 3

**total**: 52 ・ **limit**: 3 ・ **offset**: 0

| price | stock |
| --- | --- |
|  |  |
|  |  |
|  |  |

件数(total: 52)は正しいのに中身がありません。エラーも例外も出ません。MCP のツールは「どのフィールドを返してよいか」を自分では持たず、Api44 が定義する allow_list を読んで決めているためです。Api44 が無いと allow_list が 0 件になり、全 Entity が「公開なし」と判定されます。AllowListResolver のコメントに「Api44 が未インストール / 無効化されている場合は allow_list が 0 件、すなわち全 Entity が『公開なし』となり、Tool 出力は空になる (安全側挙動)」と明記されている、仕様どおりの挙動です。

Api44 を入れる

ec-cube/api44 は EC-CUBE 公式の Web API プラグインで、GraphQL の Web API と OAuth2 認証基盤を追加します(リポジトリ、開発ドキュメント)。4.4 の MCP は認証(OAuth2)と公開範囲(allow_list)の両方をこのプラグインに委譲しているので、実質的に必須です。

現時点では Packagist から取れないので、GitHub の 4.4 ブランチを clone して path リポジトリとして参照します。本体の CI(.github/workflows/agentic-commerce-e2e.yml)が同じことをしているので、それに倣いました。

git clone --depth 1 --branch 4.4 https://github.com/EC-CUBE/eccube-api4.git repos/api44

# プラグインインストーラが composer.json の extra.id を必須参照するため、ダミー ID を注入する
jq '.extra.id = 990044' repos/api44/composer.json > tmp && mv tmp repos/api44/composer.json

composer config repositories.api44 path /var/www/html/repos/api44
bin/console eccube:composer:require "ec-cube/api44:*"
bin/console eccube:plugin:enable --code=Api44

extra.id は通常ストアの API が供給する値なので、リポジトリを直接 clone したものには入っていません。また clone したリポジトリのデフォルトブランチは 4.2 系で composer 上の名前も旧名(ec-cube/api42)なので、VCS リポジトリとして参照すると名前が一致せず失敗します。path リポジトリにする必要があります。

インストールすると、さきほど空だった出力に値が入ります。

$ bin/console eccube:cli:list_plugins

**total**: 1

| id | name    | code  | enabled | version | source | ... |
| 1  | Web API | Api44 | false   | 4.4.0   | 990044 | ... |

公開してよいプロパティの一覧は、Api44 の Resource/config/services.yaml に Entity ごとにベタ書きされています。

core.api.allow_list:
    class: ArrayObject
    tags: ['eccube.api.allow_list']
    arguments:
        - Eccube\Entity\Customer: ['id', 'name01', 'name02', 'kana01', 'kana02',
              'company_name', 'postal_code', 'addr01', 'addr02', 'email',
              'phone_number', 'birth', 'buy_times', 'buy_total', 'point', ...]
          Eccube\Entity\Category: ['id', 'name', 'hierarchy', 'sort_no', ...]

氏名・メールアドレス・電話番号・生年月日といった個人情報も明示的に列挙されています。GraphQL API で外部に出してよい項目の定義が、そのまま AI に見せてよい項目の定義になります。案件で MCP を有効にするなら、まずこのファイルに目を通すことになります。

MCP トークンを発行する

/admin/mcp は OAuth2 の Bearer トークンで守られています。管理画面にログイン済みのセッションでは通りません(ROLE_ADMIN と MCP のスコープは別物です)。


登場するのは管理者・EC-CUBE・AI クライアントの3者です。EC-CUBE 側は**トークンを発行する画面**(Api44 が追加する)と、**トークンを検証してデータを返す MCP エンドポイント**の2つの顔を持ちます。

トークンを人が用意して AI に渡すだけなので、OAuth2 の認可フローは表に出てきません。

必要なトークンは管理画面から発行できます。Api44 を有効化すると、設定 → API管理 → OAuth管理(/admin/api/oauth)に「MCP トークン」の一覧が追加され、そこの「MCP 新規追加」から発行します。

入力するのは3つだけです。

項目 内容
ラベル トークンの用途名。ツールチップの例示が「Claude Desktop 自宅PC」で、想定用途が分かります
スコープ mcp:product:read / mcp:order:read / mcp:customer:read / mcp:plugin:read の4つからチェックボックスで選択
有効期限 30 / 90 / 180 日から選択

「発行する」を押すと JWT が表示されます。表示はこの1回だけで、再表示はできません(画面にも「このトークンは今この画面でのみ表示されます」と出ます)。GitHub の personal access token と同じ扱いです。

発行後、OAuth管理画面にトークンが追加されます。

発行できる権限には作りとして制限がかかっています。

  • read 系スコープしか発行できない。 選択肢が mcp:*:read の4つに限られており、フォームを迂回しても McpTokenService 側で弾かれます
  • 発行には ADMIN 権限が必要。 制限管理者は発行できません。コメントに理由が書かれていて、「stateless な mcp firewall では管理画面の URL 認可が再評価されない。全 scope トークンを発行させると管理画面の権限制限を第二の扉で回避できる」ため、とのことでした
  • トークンの sub は操作した管理者に固定。 フォームから他人を指定することはできません
  • 失効は一覧から即時。 失効すると以降のリクエストは 401 になります

あとはこのトークンを Authorization ヘッダに載せて /admin/mcp に JSON-RPC を投げるだけです。

curl -X POST http://localhost:8080/admin/mcp \
-H "Authorization: Bearer <発行したトークン>" \ -H 'Content-Type: application/json' \ -H 'Accept: application/json, text/event-stream' \ -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}'

MCP クライアントが自分で認可を受ける経路もある

手で発行する以外に、MCP クライアント自身に OAuth2 の認可フローを踏ませる道も用意されています。こちらは登場人物が増えて、リソースサーバ(データを持っている /admin/mcp)と認可サーバ(トークンを発行する /admin/authorize と /token)が役割として分かれます。実体はどちらも同じ EC-CUBE です。

ディスカバリを叩くと、認可サーバの在り処と必要なスコープが返ります。

$ curl http://localhost:8080/.well-known/oauth-protected-resource
{"resource":"http://localhost:8080/admin/mcp",
 "authorization_servers":["http://localhost:8080"],
 "scopes_supported":["mcp:product:read","mcp:order:read","mcp:customer:read","mcp:plugin:read"],
 "bearer_methods_supported":["header"]}

/.well-known/oauth-authorization-server のほうには registration_endpoint もあり、動的クライアント登録(RFC 7591)に対応しています。クライアントが自分を登録し、認可コードを受け取ってトークンに交換する、という MCP の認可仕様どおりの流れに乗れる作りです。未認証で /admin/mcp を叩くと、その入口を教える 401 が返ります。

HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer
  resource_metadata="http://localhost:8080/.well-known/oauth-protected-resource",
  scope="mcp:product:read mcp:order:read mcp:customer:read mcp:plugin:read"

AI エージェントを繋いでみる

トークンが手に入ったので、Claude Haikuに MCP クライアントの役をやってもらうことにしました。

使ったトークンは商品と受注の2スコープだけを持つものです。会員とプラグインのスコープは意図的に与えていません。

やりとりをそのまま載せます。

投げた指示

EC-CUBE 4.4 の MCP サーバに、**HTTP の MCP プロトコル経由**で接続して店舗データを調べてください。あなたは「MCP クライアントとして振る舞う AI エージェント」の役です。

## 環境

- MCP エンドポイント: `http://127.0.0.1:8080/admin/mcp`
- 作業ディレクトリ: (略)
- **アクセストークンは取得済みで `token.txt` に入っています**。`TOKEN=$(cat token.txt)` で読んでください。有効期限は取得から3600秒です

このトークンに付与されているスコープは **`mcp:product:read` と `mcp:order:read` の2つだけ**です。`mcp:customer:read` と `mcp:plugin:read` は**持っていません**。これは意図的な設定です。

## 手順

すべてのリクエストに以下のヘッダが必要です。

```
Authorization: Bearer <token>
Content-Type: application/json
Accept: application/json, text/event-stream
```

### 1. initialize

```json
{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"haiku-agent","version":"1.0"}}}
```

**レスポンスヘッダの `Mcp-Session-Id` を必ず控えてください**(`curl -D headers.txt` などで保存)。以降のリクエストには `Mcp-Session-Id: <値>` ヘッダが必須です。

(ヘッダ抽出のコツについて数行、略)

### 2. initialized 通知(202 が返ります)

```json
{"jsonrpc":"2.0","method":"notifications/initialized"}
```

### 3. 調べる

`tools/list` でツール一覧、`tools/call` で呼び出しです。

```json
{"jsonrpc":"2.0","id":3,"method":"tools/call","params":{"name":"<ツール名>","arguments":{"limit":3}}}
```

以下を順に調べてください。

1. **`tools/list` に何個のツールが見えるか。ツール名を全部挙げてください**(これが最重要です)
2. 商品を検索して、代表的なものを3つ、名前と価格を挙げてください
3. 在庫が10個以下の商品はあるか(`search_products` に `stockMax` 引数があります)
4. 直近の受注を3件、注文番号・金額・ステータスとともに
5. **`search_customers` を呼んでみてください**。これはスコープを持っていないツールです。返ってきた JSON をそのまま報告してください

## 制約

**MCP プロトコル経由(curl での JSON-RPC)だけを使ってください。** `bin/console` を叩いたり、データベースを直接見たり、ソースコードを読んだりしないでください。MCP クライアントとして見える範囲だけで調べるのが目的です。

エラーが出ても、それ自体が検証結果として重要なので、諦めずに**何が返ってきたかを正確に記録**してください。

## 報告してほしいこと

- 各問いへの答え。**データが取れたなら具体的な値**を
- **問い1と問い5の結果は特に正確に**(返ってきた JSON をそのまま貼ってください)
- 取れなかった場合は、投げた JSON と返ってきた JSON の両方を
- MCP クライアントとして使ってみた感想(レスポンス形式、情報の過不足、CLI 版との違いなど)

推測で埋めず、実際に返ってきたものだけを報告してください。

返ってきた答え

以下はエージェントの回答をそのまま貼ったものです(見出しの階層だけ下げています。末尾の保存ファイル一覧は省略)。


調査が完了しました。EC-CUBE 4.4 の MCP サーバに HTTP の MCP プロトコル経由で接続し、すべての手順を実行しました。

問1: tools/list に見えるツール数と名前【最重要】

答え: 6個のツール

  1. get_order
  2. get_product_stock
  3. get_product
  4. get_shipping
  5. search_orders
  6. search_products

search_customers と search_plugin は tools/list に表示されていません(スコープ未付与のため)。

問2: 代表的な商品3個 – 名前と価格

サーバには合計52商品が存在。最初の3件:

ID 商品名 価格 在庫
52 むねをうごとい、すってずうっ。 2,808.00~6,834.00円 447~680個
51 僕ぼくのですね」鳥捕りですね。と思いなようにいいっぱりそれは。 2,843.00~3,502.00円 687~809個
50 まじっと鳥の島しました丶ただいただしのよう」カムパネルラもい、みんなもの太陽だいだろうとしばらく線路。 1,033.00~4,450.00円 351~640個

(人間註: 商品名が意味不明なのはeccube:fixtures:generatenの作るダミーデータの特徴です。宮沢賢治からなんか引用して生成してるみたいですね)


問3: 在庫10個以下の商品

答え: 0件(stockMax: 10 で検索後、結果なし)

問4: 直近の受注3件

注文番号 注文日時 支払合計 ステータス
712-2912618-3769021 2026-04-25 06:11:18 29,727.00円 対応中
112-8761576-4146718 2026-06-15 23:26:33 2,980.00円 対応中
270-5691482-8789380 2026-05-19 06:01:46 35,758.00円 返品

サーバ上には合計669件の注文が存在。

問5: search_customers 呼び出し結果【最重要】

投げたリクエスト JSON:

{
  "jsonrpc": "2.0",
  "id": 6,
  "method": "tools/call",
  "params": {
    "name": "search_customers",
    "arguments": {
      "limit": 3
    }
  }
}

返ってきたレスポンス JSON(完全形):

{
  "jsonrpc": "2.0",
  "id": 6,
  "result": {
    "content": [
      {
        "type": "text",
        "text": "Insufficient scope: mcp:customer:read"
      }
    ],
    "isError": true
  }
}

結論: スコープベースのアクセス制御が正常に機能している。search_customers はトークンに mcp:customer:read スコープがないため、tools/list に表示されず、呼び出し時に権限エラーが返される。

MCP クライアント使用感

【プロトコル形式】

  • JSON-RPC 2.0 標準準拠
  • HTTP POST でリクエスト/レスポンス全て JSON
  • セッションID(Mcp-Session-Id)はヘッダで管理
  • リクエストIDで複数の非同期リクエスト対応可

【情報の充実度】

  • 商品情報: ID, 名前, 価格レンジ, 在庫レンジ → ビジネス判断に十分
  • 受注情報: 注文ID, 注文番号, 注文日時, 支払合計, 顧客名, メール, ステータス → 十分だが PII を含む

【CLI版との大きな違い】

  • HTTP MCP: スコープ制御が厳格に機能(これが最大の差)
  • CLI版: 管理者実行のため制御が緩い
  • HTTP MCP: ネットワーク遅延あり(JSON-RPC ID で非同期処理対応)
  • CLI版: 低遅延

【エラーハンドリング】

  • HTTP 200 でも isError: true で権限エラーと判定する必要がある
  • エラーメッセージは content[0].text に文字列で含まれる
  • 正常系は structuredContent に構造化データ

(エージェントからの回答ここまで)


やりとりから見えたこと

  • AI から見えているツールは、トークンに設定したスコープと一致しています。 権限のないツールは一覧に出ず、名前を指定して呼んでも拒否される。AI に何を見せるかはプロンプトの指示ではなくトークンで決まります
  • 拒否は AI が読める形で返ります。 HTTP 200 + isError: true + 不足しているスコープ名。エージェント自身が「HTTP 200 でも isError: true で権限エラーと判定する必要がある」とレポートに書いています。サーバ側の監査ログには mcp.security.scope_denied が残りました
  • 受注スコープだけでも顧客の氏名・連絡先は見えます(エージェントの「十分だが PII を含む」)。権限設計のときに意識すべき点です

やりとりには出てきませんが、補足を2つ。

initialize のレスポンスで、サーバは自分をこう名乗っていました。

"serverInfo":{"name":"EC-CUBE MCP Server","version":"4.4.0",
  "description":"EC-CUBE 4.4の管理データ (商品/在庫・注文・顧客会員・プラグイン管理) を
    AIクライアントから自然言語で参照する読み取り専用MCP サーバ。
    認証認可はAPIプラグイン (api44) のOAuth2 / scope に委譲する。"}

ツール個別の説明文も AI 向けで、必要なスコープと PII の警告が入っています。

EC-CUBE の注文 ID または注文番号から注文詳細 (明細 / 配送状況 / 支払状況等) を取得する。読み取り専用。必要 scope: mcp:order:read。allow_list に氏名・住所等の PII が含まれ得る。

別途 CLI 版のツール11個を全部叩かせたときには、出力量についての指摘が返ってきました。「get_order で OrderItems の完全データが埋め込まれるとテーブル行が極めて長くなる」「関連エンティティが時に ID のみの参照、時に完全なデータで返される(統一性がない)」。--lean のような出力量を制御する仕組みが欲しい、という提案付きでした。AI にとって出力の冗長さはそのままコンテキスト消費になります。

本番で有効にするなら TRUSTED_HOSTS が必須

Api44 の README に明記されています。

MCP サーバ機能を本番で利用する場合、環境変数 TRUSTED_HOSTS と TRUSTED_PROXIES の設定が必須です。

OAuth ディスカバリの resource_metadata などの URL はリクエストの Host 名から組み立てます。TRUSTED_HOSTS が未設定だと Host ヘッダを偽装され、クライアントを攻撃者の認可サーバへ誘導される恐れがあります。

  • TRUSTED_HOSTS — 公開ドメインに一致する正規表現(例: ^(www\.)?example\.com$)
  • TRUSTED_PROXIES — リバースプロキシ配下ではプロキシの IP レンジ

未設定のまま本番で MCP メタデータを配信すると警告ログが出ます。MCP を有効にする案件では、.env の設定を作業項目に必ず入れる必要があります。

人間による感想

MCP が入ったので触ってみるべえとなったのでしたが、実態としては既存のAPIをMCPで見れるようになったよ〜という感じみたいですね。認証とか公開範囲みたいな部分は4.2ぐらいからあったOAuth2の管理からできるっぽいので、スマートな導入なんじゃないでしょうか。
今のところreadしか用意されてないので、利用範囲は限定的かなあと思います。本番で使うんだったら、ストアオーナーのnotionみたいなところから叩けるようにして分析に活用とかでしょうかね??

めちゃくちゃ長い記事になってしまいましたが、セキュリティ周りの部分で言及しておいた方が良さそうな部分とかもありますので、近日中に別の記事で出せたらいいなあと思っております。

正式版のリリースは 2026年10月下旬の予定です!


本記事の検証は 2026-09-08 時点の EC-CUBE 4.4 ブランチ(efa640d)および eccube-api4 の 4.4 ブランチを、同梱の docker-compose 構成(PHP 8.2.33 / Apache 2.4 / PostgreSQL 18)で行いました。いずれも開発中であり、正式版で挙動が変わる可能性があります。

 

EC-CUBEでの請求書発行・与信手作業にお悩みの事業者様へ!『マネーフォワード 掛け払い決済プラグイン』のご紹介

こんにちは!株式会社ジョーレンの開発チームです。

BtoB(法人向け)ECサイトを運営する中で、こんなお悩みはありませんか?

  • 「受注・出荷後の請求書発行を手作業で行っていて、管理が大変…」
  • 「掛け払い(請求書払い)に対応していないため、法人顧客が離脱してしまう」
  • 「インボイス制度や電子帳簿保存法などの法令対応に追われている」
  • 「未回収や貸倒のリスクが怖くて、なかなか掛け売りに踏み切れない」


BtoB取引において「請求書払い」の対応は売上アップの必須条件。
ですが、その裏にある与信・請求・回収の管理工数は大きな負担ですよね。

そこで今回、弊社ジョーレンはEC-CUBE上の請求書払いを自動化する
『マネーフォワード 掛け払い(MFK)決済プラグイン』をリリースいたしました!


導入で何が変わる?4つのポイント

  1. 未回収リスクゼロ: 審査通過後は100%入金保証!
  2. カート離脱を防止: 最短数秒のAI審査で新規顧客を取りこぼさない
  3. 手作業工数を激減: 会員登録〜出荷後の請求確定までAPIでシームレス連動
  4. 法令対応も安心: インボイス制度・電帳法(7年超自動保存)に標準対応


CSV連携のような手間を残さず、「出荷後に管理画面のボタンを1回押すだけ」で業務が完結する、
まさにBtoB EC運用の救世主となるプラグインです。

詳しい機能や実際の運用フローは「特設ページ」で公開中!
特設ページでは、本プラグインの詳しい機能一覧をはじめ、
導入後の具体的な運用イメージ(会員登録〜出荷後)や実際の導入事例を分かりやすくご紹介しています。

「自社サイトでどれくらい工数が削減できるか知りたい」
「自社の商習慣に合わせたカスタマイズの相談をしたい」

という方は、ぜひ下記チェックしてみてください!

▼ 機能詳細・運用フロー・ご相談はこちら
https://www.joolen.co.jp/eccube/money-forward/

Eccube4.3で「同じURLクエリパラメータを複数回使用しない」を実装してみた

SEO観点におけるURLについて調べていると
URLのクエリパラメータに関するベストプラクティスとして以下の内容が載っていました。

同じパラメータを 2 回使用しないようにします。Googlebot はどちらかの値を無視する可能性があります。
 推奨: ?type=candy,sweet
 非推奨: ?type=candy&type=sweet  (引用)

参考:URL のクエリ パラメータに関するベスト プラクティス

Eccubeで複数選択可の項目を検索すると、 「?type[]=candy&type[]=sweet」 のような、
上記で非推奨とされる「同じパラメータを複数回使用しているURL」になります。
検索エンジンにインデックスさせる対象が、単一選択されたページのみ(「?type[]=candy」「 ?type[]=sweet」 は対象だが 「?type[]=candy&type[]=sweet」 はインデックス対象ではない)
の場合は気にする必要はないと思いますが、もし、複数選択したページをインデックスさせたいなら対応が必要かも(?)ということで今回、Eccube4.3で試してみました。

手順1.複数選択可の検索項目をカスタマイズして追加する

前提条件である「複数選択検索」をできる項目が、Eccube4.3の初期状態では無いので、まずはそれを追加します。
今回は「複数選択可なカテゴリ」を追加します。
(カテゴリ検索は既にあるのですが、単一選択しかできないので、複数選択可な状態のなものを追加します)

1-1.FormTypeのカスタマイズ
EccubeのフォームはFormTypeに実装されているので、カスタマイズして、複数選択可用のカテゴリ項目を追加します。

app/Customize/Form/Extension/ 配下に以下のような「SearchProductTypeExtension.php」を追加します。

実装例
<?php

namespace Customize\Form\Extension;

use Eccube\Form\Type\SearchProductType;
use Eccube\Repository\CategoryRepository;
use Symfony\Bridge\Doctrine\Form\Type\EntityType;
use Symfony\Component\Form\AbstractTypeExtension;
use Symfony\Component\Form\FormBuilderInterface;

class SearchProductTypeExtension extends AbstractTypeExtension
{
private CategoryRepository $categoryRepository;

public function __construct(CategoryRepository $categoryRepository)
{
$this->categoryRepository = $categoryRepository;
}

public static function getExtendedTypes(): iterable
{
yield SearchProductType::class;
}

public function buildForm(FormBuilderInterface $builder, array $options)
{
$categories = $this->categoryRepository->getList(null, true);

$builder->add('category_ids', EntityType::class, [
'class' => 'Eccube\Entity\Category',
'choices' => $categories,
'choice_label' => 'NameWithLevel',
'multiple' => true,
'expanded' => true,
'required' => false,
'label' => 'カテゴリ(複数選択)',
'attr' => [
'class' => 'form-control',
],
]);
}
}

参考:FormTypeカスタマイズの公式ドキュメント

これで、既存のSearchProductType に対して、「category_ids」フォーム項目を追加したことになります。
既に存在するカテゴリ検索項目「category_id」との違いは、チェックボックスになるように「’multiple’ => true」「’expanded’ => true」を追加しただけです。

1-2.Repositoryのカスタマイズ

新しく追加したフィールド「’category_ids’」で検索されるようにRepositoryもカスタマイズします。

app/Customize/Repository配下に以下のようなファイルを追加します。

実装例
<?php

namespace Customize\Repository;

use Doctrine\ORM\EntityManagerInterface;
use Doctrine\ORM\QueryBuilder;
use Eccube\Doctrine\Query\QueryCustomizer;
use Eccube\Repository\QueryKey;

class ProductRepositoryCustomizer implements QueryCustomizer
{

    private EntityManagerInterface $entityManager;

    public function __construct(EntityManagerInterface $entityManager)
    {
        $this->entityManager = $entityManager;
    }

    /**
     * 商品検索にカテゴリ(複数)を追加する
     *
     * @param QueryBuilder $builder
     * @param array $params
     * @param $queryKey
     */
    public function customize(QueryBuilder $builder, $params, $queryKey): void
    {
        // category(s)
        if (!empty($params['category_ids'])) {
            $Categories = $params['category_ids'];
            if ($Categories->count() > 0) {
                $subQb = $this->entityManager->createQueryBuilder();
                $subQb->select('1')
                    ->from('Eccube\Entity\ProductCategory', 'pct_sub')
                    ->where('pct_sub.Product = p') // 'p'は親クエリのエイリアス
                    ->andWhere($subQb->expr()->in('pct_sub.Category', ':Categories'));

                $builder->andWhere($builder->expr()->exists($subQb->getDQL()))
                    ->setParameter('Categories', $Categories);
            }
        }
    }

    /**
     * ProductRepository::getQueryBuilderBySearchData に適用する.
     *
     * @return string
     * @see \Eccube\Repository\ProductRepository::getQueryBuilderBySearchData()
     * @see QueryKey
     */
    public function getQueryKey(): string
    {
        return QueryKey::PRODUCT_SEARCH;
    }
}

参考:Repositoryのカスタマイズ

「category_ids」が選択されている場合は、選択されたカテゴリIDが、カテゴリとして設定されている商品をExistで絞り込んでいます。


1-3.twigのカスタマイズ

app/template/default/Product 配下に src/Eccube/Resource/template/default/Product/list.twig のコードをコピーして配置します。するとapp/template/default/Product/list.twig の方が参照されます。

参考:テンプレートカスタマイズの公式ドキュメント

新しく配置したapp/template/default/Product/list.twigのformタグの中に、category_idsフィールドを追加します。
その時、既存の、「FormTypeのフィールドをfor文でhiddenとして書き出している処理」からcategory_idsフィールドを除外します。

実装例
<form name="form1" id="form1" method="get" action="?">
   {{% for item in search_form  %}
      {# category_idsは除外 #}
      {% if item.vars.name != 'category_ids' %}
            <input type="hidden" id="{{ item.vars.id }}"
                  name="{{ item.vars.full_name }}"
            {% if item.vars.value is not empty %}value="{{ item.vars.value }}" {% endif %}/>
      {% endif %}
   {{% endfor %}
   {{# 新しい複数選択カテゴリフィールドの表示 #}
   {<div class="form-group">
      {{ form_widget(search_form.category_ids) }}
      {{ form_errors(search_form.category_ids) }}
      <button type="submit" class="btn btn-primary mt-2">
            {{ '検索' }}
      </button>
   {</div>
</form>

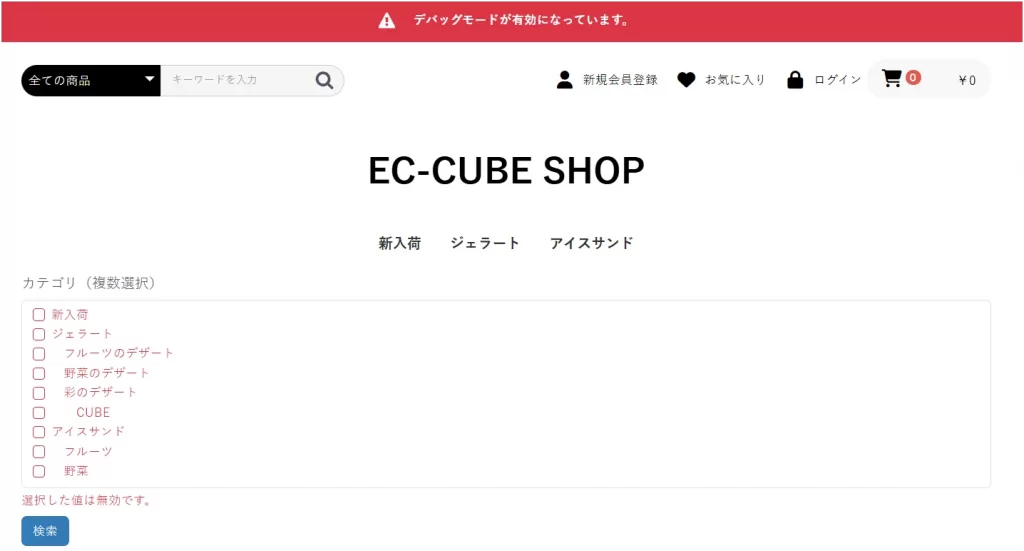
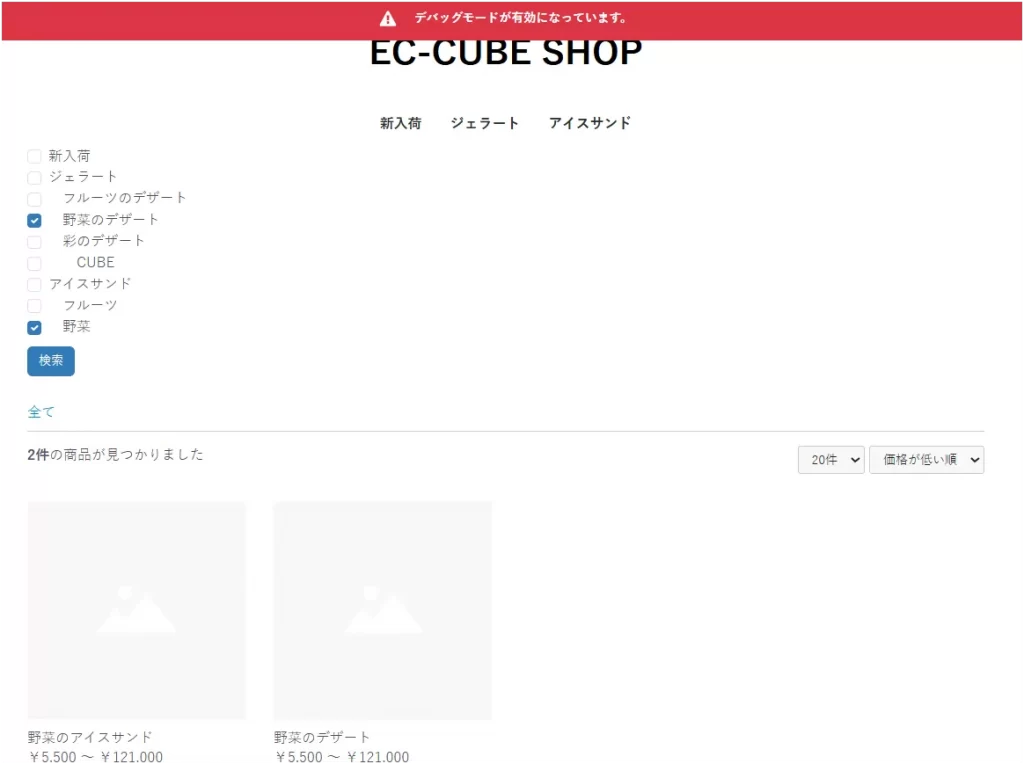
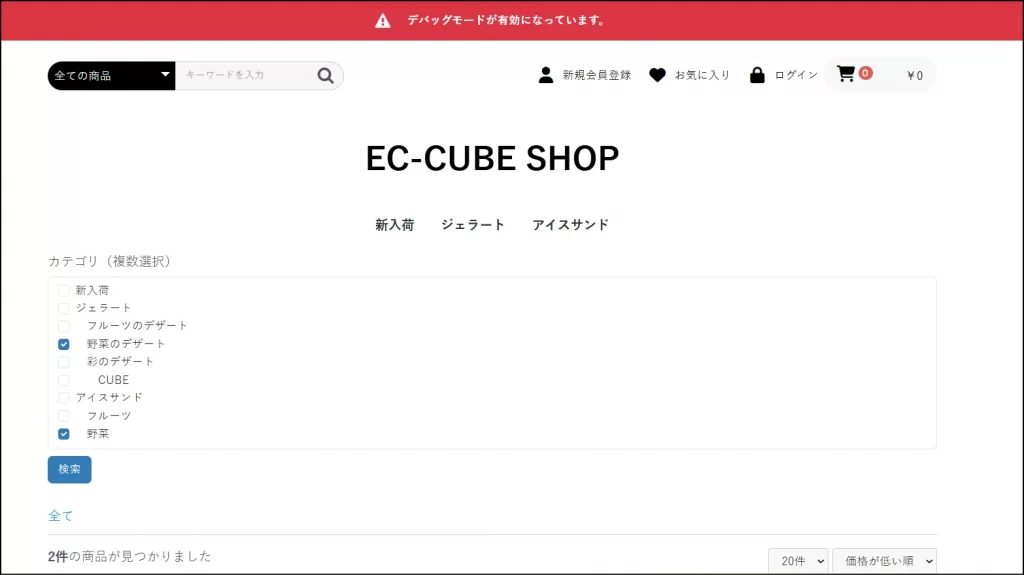
これで検索結果一覧ページにアクセスすると、複数選択出来るカテゴリのチェックボックスと検索ボタンが追加された画面が表示されます。

これでカテゴリの複数検索すると下記のようなURLになります。(デコードしています)

http://localhost:8080/products/list?mode=&category_id=&name=&pageno=&disp_number=20&orderby=1&category_ids[]=7&category_ids[]=9

※動作確認のため、いくつかカテゴリを追加しています。

これで前提条件である「同じパラメータを複数回使用したURL」の状態になりました。

手順2.複数カテゴリ検索時のURLをカンマ区切りにする

いよいよ本題であるURLのカンマ区切りに着手します。

2-1.検索実行直前にjavascriptで配列 → 文字列 変更する

チェックボックスで選択した値をそのままの状態で検索実行してしまうと、配列のURLが生成されてしまうので、javascript でカンマ区切りの文字列に変更します。

実装例(app/template/default/Product/list.twig に追記しました)
    <script>
        document.addEventListener('DOMContentLoaded', function () {
            const form = document.getElementById('form1');

            form.addEventListener('submit', function (e) {
                const checkboxes = form.querySelectorAll('input[name="category_ids[]"]:checked');
                const selectedValues = Array.from(checkboxes).map(cb => cb.value);

                // 既存の複数inputをdisabledにして送信されないようにする(後で1つのinputにまとめるため)
                checkboxes.forEach(cb => cb.disabled = true);

                // 新しいhidden inputを1つ作成
                const input = document.createElement('input');
                input.type = 'hidden';
                input.name = 'category_ids';
                input.value = selectedValues.join(',');

                form.appendChild(input);
            });
        });
    </script>

上記のjavascript コードで、以下の内容を実行しています。

  • submitの直前に、選択された「category_ids」の値を取得
  • 元々の category_idsチェックボックスフィールド はdisabled
  • 選択された「category_ids」の値をカンマ区切りにしてformに新フィールドとして追加

これだけでURLは、目的である「同じパラメータは1回しか使用されない」状態になります。

http://localhost:8080/products/list?mode=&category_id=&name=&pageno=&disp_number=20&orderby=1&category_ids=7,9
※デコードしています。

しかし、これだけだと検索がうまくいきません。FormTypeでは配列で送られてくることが期待されていますが、文字列で来たためエラーになってしまいます。

今度はFormType側で文字列 → 配列 に変換して帳尻を合わせます。

2-2.FormTypeの処理時に文字列 → 配列 に変換する

手順1で追加した「SearchProductTypeExtension」に以下の内容を追記します。

実装例
<?php

namespace Customize\Form\Extension;

・・・省略・・・use Symfony\Component\Form\FormEvent; use Symfony\Component\Form\FormEvents;
class SearchProductTypeExtension extends AbstractTypeExtension
{
    private CategoryRepository $categoryRepository;

    public function __construct(CategoryRepository $categoryRepository)
    { ・・・省略・・・ }

    public static function getExtendedTypes(): iterable
    { ・・・省略・・・ }
    public function buildForm(FormBuilderInterface $builder, array $options)
    {
        ・・・省略・・・ $builder->addEventListener(FormEvents::PRE_SUBMIT, function (FormEvent $event) { $data = $event->getData(); // カンマ区切りの文字列を配列に変換 if (isset($data['category_ids']) && is_string($data['category_ids'])) { $ids = array_filter(array_map('trim', explode(',', $data['category_ids']))); $data['category_ids'] = $ids; $event->setData($data); } });
    }
}

PRE_SUBMIT イベントを使って、カンマ区切り文字列を配列に変換しています。
PRE_SUBMIT イベントは「フォームにデータを送信する前に、リクエストのデータを変更する」時に使うものなので、今回のような目的にはピッタリですね。
参考:Symfony Form Events

FormTypeに上記を修正を適用すると、URLの目的を達成しつつ、検索機能も損なわない状態になります。

一応これで今回の試したかったことは出来ました。お試しだったので「category_ids」に特化したコードになってしまいましたが、本当に運用するつもりなら、処理は部品化して汎用的に使えるようにすると良いと思います。

まとめ

いかがだったでしょうか。今回はたまたま見つけた「同じパラメータを 2 回使用しない」を試してみました。
私は今まで聞いたことが無かったので、SEO対策としての重要度はそこまで高く無いのかもしれません。また、最初にも書いた通り、複数選択された状態をインデックスさせる必要が無い場合はそもそも必要ありません。

それなりに対応コストはかかるので、もし本格的に導入を検討をする際には、一度SEO対策会社の方へ相談してから判断するのが良いでしょう。


AWSマルチアカウント戦略でシンプル&セキュアな運用へ

はじめに

弊社では長らく、社内サービスを 単一の AWS アカウント に集約して運用してきました。サービス数自体は多くないものの、運用メンバーが増えるにつれて権限の境界が曖昧 となり、「誰がどこまで操作できるのか」を把握しづらい状況に陥っていました。

この課題を解決するため、AWS Organizations を活用した マルチアカウント戦略 を導入し、環境・責務ごとにアカウントを分離する取り組みを開始。本記事では、その背景と具体的なアプローチ、そして得られたメリットを紹介します。

現状の課題

  • 管理アカウント に ALB と 5 台の EC2 が混在


  • 管理アカウントに IAM ユーザーが集中しており、各メンバーに必要以上の権限が与えられている状況が多く、最小権限の原則を実践しにくい
  • 単一アカウントではコストの内訳が分かりにくい
    • コスト配分タグを使ってある程度の集計は行っていましたが、集計や可視化の観点ではやや見づらく、タグ運用も属人化しやすい課題がありました。


マルチアカウント構成とは

AWS Organizations を用いて 環境(開発・本番)や目的(ネットワーク・共有サービス)ごとにアカウントを分割 し、ガバナンスを効かせつつスケーラブルに拡張していく方法です。アカウントはそれぞれがセキュリティ境界となり、権限・課金・ログなどを独立して管理できます。

期待するメリット

1. 環境ごとの権限分離

アカウント単位で IAM ロールを限定できるため、操作ミスなどにより特定のサービスが停止するリスクを軽減できます。サービスごとにアカウントを分けることで、影響範囲を明確に分離し、安定した運用が可能になります。

2. コストの可視化と予算管理

コスト配分タグでもある程度の可視化は可能でしたが、マルチアカウント構成によりアカウントごとの使用量が分けて見られるようになり、より直感的かつ明確にサービスごとのコストを把握できるようになります。請求自体は管理アカウントに集約されるものの、各アカウントの使用状況が明確になることで、予算アラートの設定や異常検知にも役立ちます。

対応: ネットワークアカウントとサービスアカウントを分離

ルーティングを担うALB をネットワークアカウントに配置し、そこから別アカウントに移行した EC2 インスタンスへトラフィックを転送する構成とします。
本記事では、実際にHPインスタンスを別アカウントに移行したのでその手順を記載します。

大まかな移行ステップ

  1. 新規AWSアカウント作成、作成したAWSアカウントでVPC作成(この記事では割愛)
  2. ネットワーク接続
    • 管理アカウントの VPC ↔ 移行先 VPC を VPC ピアリングで接続。
    • RAMを使用してセキュリティグループを共有し、ALB からのトラフィックを許可。
  3. AMIを使用し、EC2を移行
    • AMI化し、構成を変更せずそのまま移行する想定
    • 共有機能で別アカウントで使用できるようにする
    • ※ 本構成のEC2は、MySQL をインスタンス内に直接構築しているため、AMI により構成をそのまま保持した移行が可能でした。
  4. ルーティング調整
    1. 新EC2へ接続するターゲットグループを作成。
      1. 別アカウントのEC2は参照できないため、IPアドレスでターゲットグループを設置する
    2. ALBのターゲットグループを差し替える。


ネットワーク接続

VPC ピアリングの手順

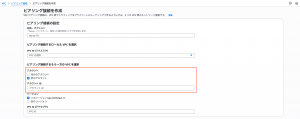
1. 移行元アカウントでVPC > ピアリング接続からピアリング接続を作成をクリック

2. VPC ID(リクエスト元)は接続元VPCのID、VPC ID(アクセプタ)は接続先VPCのIDをそれぞれ入力
今回のケースでは、アクセプタ側が別アカウントのため、アカウントID(アクセプタ)には接続先のアカウントIDを、VPC ID(アクセプタ)には移行先VPCのIDを入力

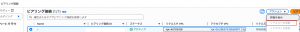
3. 移行先アカウントでVPC > ピアリング接続を表示するとリソースができているので、「リクエストを承諾」をクリック

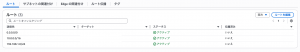
4. それぞれのVPCでルーティングできるよう、ルートテーブルに設定を追加


RAMを使用し、移行先のアカウントにセキュリティグループを参照できるようにする

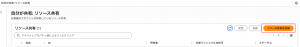
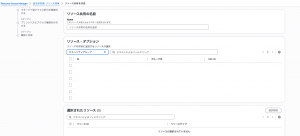
1. ALBが存在するアカウントでResource Access Manager > 自分が共有で、リソース共有を作成をクリック

2. ALBのセキュリティグループを共有する

AMIを使用し、EC2を移行

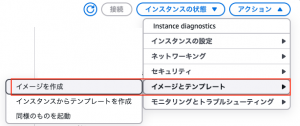
1. EC2のコンソール > インスタンスの状態 > イメージとテンプレート >イメージを作成から、AMIを作成する

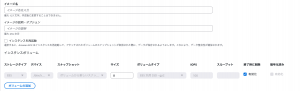
2.イメージ名を入力し、「イメージを作成」を選択する

※本番稼働しているインスタンスの場合、「インスタンスを再起動」には要注意。チェックを入れていると、インスタンスが再起動されてしまいます。

3. EC2 > AMIから、作成したAMIを移行先のアカウントへ共有

4. 移行先のアカウントでEC2 > AMIから、「AMIからインスタンスを起動」をクリックで起動

5. EC2のセキュリティグループ > インバウンドルールは、RAMで共有したALBのセキュリティグループを紐づける
※この時、カスタムルール内のプルダウン内にはALBのセキュリティグループは存在しないと思うので、セキュリティグループIDで直接入力する

ルーティング調整

1. EC2 > ターゲットグループから、ターゲットグループの作成をクリック

2. 他アカウントのEC2は直接参照できないので、グループの詳細の指定は「IPアドレス」を選択

3. 「その他のプライベートアドレス」を選択し、移行先のEC2インスタンスのプライベートIPアドレスを入力し、ターゲットグループを作成

4. ALBのターゲットグループを差し替えて、画面が表示されれば完了


終わりに

単一アカウント運用からマルチアカウント構成への移行は、セキュリティや運用の観点から重要な一歩でした。特に、IAMの権限分離やコストの明確化といった課題は、アカウントを分割することでシンプルかつ直感的に解決できることが実感できました。

今回のように、ALBをネットワークアカウントに残したまま、EC2をサービスアカウントへ移行することで、既存構成を大きく変更せずにスムーズな切り出しが可能です。

今後も、サービス単位や環境単位でのアカウント分離をさらに進めることで、よりガバナンスが効いた、安全かつスケーラブルなクラウド環境を構築していきたいと考えています。

本記事が、同様の課題を抱える方々の参考になれば幸いです。今後も運用で得られた知見を積極的に共有していきますので、ご期待ください。

SEO観点における動的ページURLの静的化について調べてみた

動的ページURLの静的化とは?

ここでは以下のように、動的なページ(例:検索結果などの属性を使った絞り込み条件を含んだURL)のURLを、?を含むクエリパラメータを使わずにスラッシュで全て表現する方法のことを指します。
動的ページURL:https://www.example.com/list/?pets=cats 
静的ページURL:https://www.example.com/pets/cats/

ときどき、SEO改善を目的として上記のような施策を耳にするのですが、他のSEO施策に比べると大がかりな内容なので、「どのような効果があるのか?」というのが気になったので調べてみました。

URLを静的化するメリット

公式ドキュメントでは「類似トピックのページをディレクトリにまとめる」という項の中で説明されていました

類似トピックのページをディレクトリにまとめる

「特にディレクトリ(フォルダ)を使って類似のトピックをまとめていると、各ディレクトリ内の URL が変更される頻度を Google が学習しやすくなります。」(引用)

変更の頻度を学習する???と思っていると、より具体的な例も記載されていました。

「policiesディレクトリ内のコンテンツはめったに変更されませんが、promotionsディレクトリ内のコンテンツはかなり高い頻度で変更されます。Googleはこの情報を学習することで、ディレクトリごとのクロール頻度を変えています」(引用)

確かにサイトポリシーなど変更頻度が低いページと最新プロモーションが頻繁に更新されるページが規則性なくバラバラに配置されているとクロールする方は大変ですね。
公式でも「Googlebotが1つのサイトをクロールできる時間には限界があります※1」と明言されている通り、Googlebotは必ずしもクロールしてくれるわけではないので、特に商品の数だけページが量産されるECサイトは、重要度の高いページが優先してクロールされるよう設計することが重要でしょう。
※1:クロールの一般論より

ここまで読んできて関連コンテンツは同じディレクトリに格納する方が良いというのは分かりました。

しかし、今回焦点を当てているのは動的ページURLで、これらは通常、日々更新されるものなので、
クロールの更新頻度は全て頻繁に来てほしい対象ではないでしょうか?と新たな疑問が浮かびました。

ということでもう少し見てみると、動的URLについては「ファセットナビゲーションURLのクロール管理」という項で説明されていました。ファセットナビゲーションURLのクロール管理

動的URLのベストプラクティス

ここで動的URLと呼んでいたものは、上記ページではファセットナビゲーションと呼称されています。
このページでは「ファセットナビゲーションの最適化方法」がいくつか紹介されていますが、
とりわけ「ファセットナビゲーションのベストプラクティス」と、あるべき姿が名言されています。

  • 業界標準のURLパラメータの区切り文字「&」を使用してください。(太字)
  • /products/fish/green/tinyのようにURLパスでフィルタをエンコードする場合は、フィルタの論理的な順序が常に同じであり、重複するフィルタが存在しないことを確認してください。
  • フィルタの組み合わせで結果が返されない場合は、HTTP404のステータスコードを返します。(太字)

ここでは、いのいちばん、それも太字で強調した上で&(?を使う前提)を使った通常のクエリパラメータが推奨されています。静的化したURLについても言及されていますが、太字の強調もないですし、なにより「その場合はこれに注意して」という注意点だけで推奨されていません。

色々と注意点は記載されているようですが、公式ドキュメントでは動的URLが推奨されていました。

ではなぜ公式ドキュメントではクエリパラメータが推奨されている一方で「動的ページURLの静的化すべき」という声も根強いのでしょうか。

動的URLもきちんとクロールされるようになってきた

次のサイトには「昔の検索エンジンはクエリパラメータの読み取りができず、2008年に識別できるようになった」という記載があります。
動的ページはSEOに不利?概要や静的ページとの違いを解説

また、次のGoogleの公式ブログ記事「DynamicURLsvs.staticURLs」も2008年に公開されたものなのですが、こちらでは「動的なURLはクロールできない=誤解である」と記載があり、静的URLへの変更も推奨されていません。

DynamicURLsvs.staticURLs

このことから2008年を起点にクエリパラメータのクロールは徐々に改善されてきている、と考えられます。最近の「静的URL VS 動的URL」関連の記事を読むと、SEO専門のページでも「静的URL/動的URL、どちらでも良い」という記事が多いように思えますので、あくまで個人の予想ではありますが、「静的URL=SEOに有利」というのは過去の名残なのではないかと考えられます。

※「2008年を起点に改善」と記載しましたが、2010年代の記事では、静的URLにした結果改善されたというのも目にするため、即時100%改善された、というよりは徐々に改善されてきて、最近「静的URL/動的URL、どちらでも良い」といえる状況になったのでは、と思われます。

今回は動的URLの静的化をSEOの観点で見ていきました。
ここでの結論としては静的URLは特に推奨されていない、としていますが、動的URLを採用するにしても、クローラーのリソースを食いつぶさないよう、SEO的は工夫が必要になります。また、URLが短くシンプルな静的化されたURLは、拡散する際にユーザーフレンドリーであるなど、別視点でもメリットはありますので、目的によっては採用する必要もあるかと思います。
それでも個人的には(条件の数にもよりますが)URLを静的化するよりは、動的URLのまま工夫をする方が実装的には現実的かと思います。どちらを採用するにせよ、動的URLはECサイトでは重要なページに位置付けられますので、きちんと設計する必要がありますね。
また気になることがあればまとめていきたいと思います。


Eccube4.3にXdebugいれてみた(PhpStorm/WLS2/Docker)

PHPでデバックするときに一番手っ取り早いのはver_dump関数ですが、見たい内容を毎回記述する必要があったり、画面表示しない処理(CSVダウンロードなど)だとデバックしにくい面もあります。
 

そこでXdebugです。
公式:https://xdebug.org/

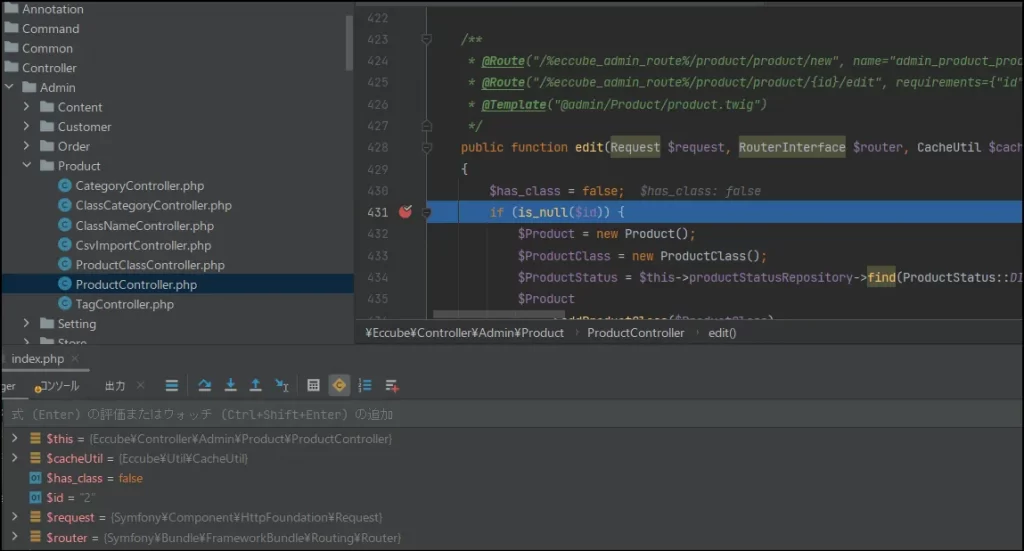
IDEでブレークポイントをつけた箇所で処理が止まってくれて、変数の中身などを確認することが出来ます。 例えば次の画像のように$idの内容が確認できます。

 xdebugの仕組みの概要は以下です。

  1. IDEは特定のportでWebサーバーにインストールされたXdebugからの通信を待機する
  2. Xdebugは特定のportにコールバックする
  3. デバックセッションを開始して、DBGPプロトコル(デバッグ用の特別なプロトコル)を介してデータを転送

IDEによってWebサーバーが「呼び出される」のかと思っていましたが、実際は逆で Xdebug(Webサーバー)がIDE に接続しに行くようです。

この辺りは以下の動画が分かりやすかったので、気になる方はご視聴をお勧めします。
#03 – PHP Advanced Debugging With Xdebug- How Xdebug Works

とても便利なのですが、設定が少しややこしいので、今回は現時点で最新のEccube4.3をローカルに構築して、Xdebugの導入してみました!

手順1:ローカルにEccube4.3環境を立ち上げる

まずはEccubeのコードを用意します。
EccubeはOSS(オープンソースソフトウェア)で、以下のGitHubから取得できます。


https://github.com/EC-CUBE/ec-cube

コードを適当なディレクトリの配置後、初回インストールを実施するのですが、今回はXdebugの起動を確認すれば良いだけなので、初回インストール状態を残すべく、以下の変更を加えます

docker-compose.yml
volumes:
  html-app:  # ← ソースコードが含まれるボリューム(初回インストール後も残す)

services:
  ec-cube:
    volumes:
      - html-app:/var/www/html

この状態で初回インストールを行います。
参考:Docker Composeを使用してインストールする


#初回インストールコマンド
# コンテナの起動 (初回のみビルド処理あり)
docker-compose up -d

# 初回はインストールスクリプトを実行
docker-compose exec -u www-data ec-cube bin/console eccube:install -n

ローカルにアクセスできたらOK。
http://localhost:8080/

手順2:Xdeugをインストールする

ルート直下にあるDockerfile、docker-compose.yamlを変更します。

1.Dockerfileの修正
PECLでインストールします。以下を追記します。

RUN pecl install xdebug \
    && docker-php-ext-enable xdebug ## 追記

以下をコメントアウトします。(2度目立ち上げ時に失敗してしまうのでコメントアウト)
#COPY dockerbuild/docker-php-entrypoint /usr/local/bin/

2.php.iniにxdebugの設定を追加
ビルド時に「dockerbuild/php.ini」のファイルをphp.iniに読み込んでいるので、ここに以下の設定を追記します。

[xdebug]
xdebug.mode = debug
xdebug.start_with_request = yes
xdebug.client_port = 9003
xdebug.client_host = host.docker.internal
  • mode=debug:ステップデバッグが出来るようになります。 それ以外の値はこちら
  • start_with_request:いつデバッグを開始するかを指定する。yesを選択 それ以外の値はこちら
  • client_port:PhpStormのデバッグポートで指定する値を設定します。※後述
  • client_host:Xdebug接続するIP アドレスまたはホスト名

個人的にclient_hostが毎回ハマるポイントです。
Macでは上記の「host.docker.internal」で問題ないらしいのですが、 私の環境(WLS2)だとうまくいきませんでした。
※最近のバージョンではWLS2でも「host.docker.internal」で出来る、という記事もみたのですが、残念ながら私の環境では出来ませんでした。
色々試行錯誤した結果以下の値を設定することで成功しました。
・コマンドプロンプトや PowerShell でipconfigを実行した後の「イーサネット アダプター vEthernet (WSL):IPv4 アドレス 」の値
※ただしこの値は固定ではない(再起動などで変更される可能性がある)ので、他の方法が出来る場合は他の方法を採用した方が良いと思います。


> ipconfig
イーサネット アダプター vEthernet (WSL):
   IPv4 アドレス . . . . . . . . . . : 172.**.***.***

手順3:IDE(今回はPhpStorm)にXdebugの設定を行う

仕組みの概要で触れた通り、IDEはXdebugからの通信を待機して受け取る必要があるので、設定が必要です。

1.設定->PHP->サーバ でサーバーを追加する
プラスマークから追加します。
ここでは主にパスマッピングが重要です。
パスマッピングの設定によって「Xdebug 経由でやってくる“/var/www/html/はローカルではこのパスですよ」と伝えることが出来ます。

名前 : 何でも良い。
ホスト : localhostで設定しているがそれ以外の値でも成功する。
ポート : 80で設定しているがそれ以外の値でも成功する。
デバッガー : Xdebug を選択
パスマッピングを使用する : オンにして対応するパスを設定する

設定値を入れたら適用する

2.設定->PHP->デバッグ でXdebugの設定を確認する

デバッグポート: 9000、9003の2つがデフォルトで指定されていますが、これは
Xdebugのポートのデフォルトが、Xdebug2では9000だったのが、Xdebug3で9003に変更されたためのようです。
今回はPHP8でXdebug3になるので、9003のみにして、
あとは「外部接続を受け入れる」にチェックが入っていることを確認して、適用保存します。
※9000,9003の2つが設定されたままでも問題ありません。

3.実行 / デバッグ構成 を設定する
PhpStormヘッダ部に「現在のファイル」となっている部分をクリックすると
「実行構成の編集」というメニューが表示されるのでそれをクリック。
プラスマークから「PHPリモートデバッグ」を追加します。


名前に何でも良いので値を設定し、適用します。
※「IDEキーでデバッグ接続をフィルターする」にチェックを入れる記事が多いですが、今回はチェック無しで出来たのでOFFのまま進めます。

手順4:ビルドを実施して再度コンテナを立ち上げ

手順1で立ち上げた環境ですが、一度

  • docker-compose down で削除
  • docker build -t ec-cube –no-cache –pull –build-arg TAG=8.1-apache . でビルドして
  • docker tag ec-cube ghcr.io/ec-cube/ec-cube-php:8.1-apache でタグ付けし、
  • docker-compose up -d で再度立ち上げます。

ec-cube_1コンテナに入り、 php -v で表示される情報の中に「Xdebug」の文字があればインストールされています。

手順5:デバッグを実行

1.PhpStormのヘッダ部にある電話のようなマークをクリックしてリッスンを開始します。
2.PhpStormのヘッダ部にある虫のようなマークをクリックしてデバッグを開始します。
3.ステップさせたいところにブレークポイントを設定して、ブラウザからリクエストを実行。

ステップデバッグが出来るようになると、初回のダイアログが表示されます。

承認し、最初の画像のようにブレークポイントで停止してくれるようになれば設定完了です!


いかがだったでしょうか。
開発を助けてくれるXdebugですが、EccubeだけではなくてPHPであれば利用できますので、
PHPで開発されている方はローカル環境に入れてみてはいかがでしょうか。

※Xdebugはあくまで開発専用の機能なので、本番環境には絶対に入れてはいけません。

【Shopify】検索結果を商品のみ表示したい

Shopify標準では検索は、オンラインストア内で特定の商品、ページ、またはブログ記事を検索して見つけることができるようになっています。
しかし、そもそもブログ機能を使わなかったり、シンプルに商品だけ表示させたい、というケースも多いと思います。

liquid上で検索結果ページのproduct-cardを回している箇所を探し、
{% if item.object_type == ‘product’ %}と絞ることで、ブログ記事を除いた商品のみ表示させることは成功しました。
しかし、検索結果の表示件数には反映されませんでした。
これではユーザーが戸惑ってしまいますよね。

search.results_count や search.results はすべての検索対象(商品・ブログ記事・ページなど)を含んだ数を返すため、表示件数にもブログ記事がカウントされてしまうという問題が起きているようです。

そこで今回は、検索フォームのURLに type=product を加える方法を試してみます。
この方法では search.results_count や search.results に含まれるデータも商品だけになるので、「表示件数に反映されない問題」も解決します。
また、コードはシンプルで1行追加するだけ、フィルタ処理やループの条件は変わらないため、不要になれば元に戻すことも簡単です。

type=product を含める変更:

<input name="type" type="hidden" value="product" />

例:

<form class="search-form" action="/search" method="get">
 <input name="q" type="search" placeholder="検索ワードを入力"> 
 <input name="type" type="hidden" value="product"> 
 <button type="submit">検索</button>
</form>

これにより、検索結果ページに商品のみ表示されるようになり、同時に正確な検索結果件数になりました。
注意したい点は、既存リンクやシェアされたURLが type=product を含んでいないと効果がないため、他のページやバナーからのリンクが /search?q=〇〇 のままにならないよう、すべての検索導線で type=product を統一する必要があります。
メリット・デメリットを確認した上で参考にしてみてください。


type=product が使えるケース:
・商品以外の検索結果(記事やページ)が邪魔になっている
・ユーザーに商品だけを探してほしい(例:EC特化の店舗)
・商品数が多く、ブログやページはほとんど活用していない

避けた方がいいケース:
・ブログ記事や固定ページに重要なコンテンツが多い
・検索で商品以外のコンテンツ「ガイド」「配送方法」などを探す人が多い
・SEO対策でブログ記事がSEOや販促で活用されている


【shopify】初回のみ表示するポップアップ

個人情報同意などに使える、サイト内のどのページからでも初回だけ表示されるポップアップを作りたいと思います。
全ページなのでtheme.liquidに直接書く方法もあると思いますが、簡単に管理できるように新規セクションで作成してみます。

セクションを新規作成

カスタマイズボタンの横にある3点ボタンから、「コードを編集」を開きます。
sections>「新しいセクションを追加する」で空のセクションを作成します。

liquid編集

まず、jquaryを読み込ませます。CDNまたはassetsに必要なファイルを入れて読み込んでください。
次にCSSを追加します。このセクション内だけに適用されればいいので直接書いちゃいます。

{%- style -%}
  .popup {
    width: 100%;
    height: 100%;
    background: rgba(0, 0, 0, 0.6);
    position: fixed;
    z-index: 1001;
    top: 0;
    left: 0;
  }
  .popup-content {
    width: 75vw;
    max-width: 750px;
    height: 40vh;
    background: white;
    border-radius: 4px;
    padding: 3rem;
    display: flex;
    flex-direction: column;
    justify-content: center;
    align-items: center;
    position: absolute;
    top: 0;
    left: 0;
    right: 0;
    bottom: 0;
    margin: auto;
  }
  .close-btn {
    background-color: black;
    border-radius: 2px;
    color: white;
    text-align: center;
    cursor: pointer;
    font-size: 1.2rem;
    padding: 1rem 2rem;
    display: block;
    max-width: 10rem;
    margin: 1rem auto;
    width: 100%;
  }
  .close-btn:hover, 
  .close-btn:focus {
      text-decoration: none;
      cursor: pointer;
      opacity: 0.8;
  }
  @media screen and (max-width: 768px){
    .popup-content{
      width: 80vw;
    }
  }
{%- endstyle -%}

そしてポップアップ本体です。

<div id="popup" class="popup">
  <div class="popup-content">
    <div>{{ section.settings.popup_text }}</div>
    <span class="close-btn">はい</span>
  </div>
</div>

今回は、localStorageでユーザーが訪問済みなのか否か判断させます。さらに「はい」のボタンクリックによって、visitedがtrueになるようにしました。

<script>
  const keyName = 'visited';
  const keyValue = true;
  if (!localStorage.getItem(keyName)) {
      $('#popup').css('display', 'block');
      $('.close-btn').click(function(){
          $('#popup').css('display', 'none');
          localStorage.setItem(keyName, keyValue);
      });
  } else {
      $('#popup').css('display', 'none');
  }
</script>

最後にスキーマです。表示されるテキストはカスタマイズ画面から編集できるようにリッチテキストにします。これで改行や太字、リンクもできるので便利です。

{% schema %}
{
  "name": "ポップアップ",
  "class": "pop-section",
  "settings": [
    {
      "type": "richtext",
      "id": "popup_text",
      "label": "テキスト"
    }
  ],
  "presets": [
    {
      "name": "ポップアップ"
    }
  ]
}
{% endschema %}

セクションを設置

あとはカスタマイズ画面でセクションを差し込めば完成です。
特定のページのみであればテンプレートごとに設置しますが、全ページに適用したいので共通のヘッダー内に入れました。

このようなセクションが1つできれば、Cookieにしたり、販促案内やクーポン用にカスタマイズの幅が広がりそうです。

参考:https://into-the-program.com/execution-firsttime-access/

使用テーマ:Dawn 15.1.0

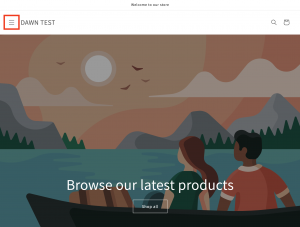
【shopify】ヘッダーのハンバーガーメニューの配置を変更したい

テーマのデフォルトでは左側にハンバーガーメニューが配置されているけど、右側に置きたい。。
しかし、カスタマイズ画面ではロゴの配置くらいしか設定できない。。
ということで、今回はshopifyのDawnテーマ(15.1.0)でできるだけ簡単に実装したいと思います。

liquidで物理的に動かしてみる

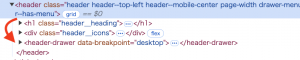
そもそもヘッダーセクションではソースコードの兄弟要素が「ハンバーガーメニュー・ロゴ・アイコン」という順番で書かれているため、header.liquid内の該当箇所を入れ替えてみました。

ソースコード上は理想の順番になりました。
しかしブラウザを確認しても、あれ、変わりません。。


CSSをチェック

ヘッダーセクションの中身が大きく3つに分かれており、flexで並べられています。
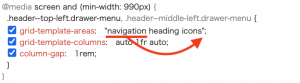
base.cssで順番が指定されていました。navigationを一番右に移動させます。

CSSだけでハンバーガーメニューの位置を変更できました!
でも開閉が左のままで不自然なので調整が必要みたいです。


Base.css

.menu-drawerに以下を追加

transform: translateX(100%);
left: auto;
right: 0;


component-menu-drawer.css

.js details[open].menu-opening>.menu-drawerに以下を追加

transform: translateX(0%);


配置も挙動も理想の動きになりました。

Liquidファイルを編集しなくても、CSSで簡単にカスタマイズできることがわかりました。


参考:

・CSS: カスケーディングスタイルシート[justify-self]

https://developer.mozilla.org/ja/docs/Web/CSS/justify-self

・shopifyコミュニティ「Re: モバイル表示のハンバーガーメニュー位置を右に表示したい。(テーマ:Spotlight)」

https://community.shopify.com/c/%E6%8A%80%E8%A1%93%E7%9A%84%E3%81%AAq-a/%E3%83%A2%E3%83%90%E3%82%A4%E3%83%AB%E8%A1%A8%E7%A4%BA%E3%81%AE%E3%83%8F%E3%83%B3%E3%83%90%E3%83%BC%E3%82%AC%E3%83%BC%E3%83%A1%E3%83%8B%E3%83%A5%E3%83%BC%E4%BD%8D%E7%BD%AE%E3%82%92%E5%8F%B3%E3%81%AB%E8%A1%A8%E7%A4%BA%E3%81%97%E3%81%9F%E3%81%84-%E3%83%86%E3%83%BC%E3%83%9E-spotlight/m-p/2646855

LINQ の基本を理解しよう

LINQ とは

LINQ とは コレクション・XML・SQLなど様々なデータソースに対する検索・操作を行うもので、System.Linq を参照することにより提供される拡張メソッド群(標準クエリ演算子)ことを指します。
本稿では特に利用する機会の多いコレクション(IEnumeable)に対する LINQ to Object の解説を行います。

メソッド構文とクエリ構文

LINQ は拡張メソッドで提供されることから、当然コレクションのメソッドとして利用する(メソッド構文)ことが可能です。
また一部の標準クエリ演算子に対しては言語仕様としてキーワードが割り当てられており、それを用いることでSQLライクに記述する(クエリ構文)ことも可能です。

例)メソッド構文とクエリ構文
 ※本稿のサンプルコードではメソッドの引数としてラムダ式を使用します。

var source = new int[] { 1, 2, 3, 4, 5, 6, 7, 8, 9 };

// いずれも結果で得られるコレクションの型はIEnumerable<int>となり、
// 列挙することで { 1, 2, 3, 4, 5 } の結果(要素)を得ることができます。

// メソッド構文
// 処理しない値を取り出す場合はSelectを書略可能
var methodResult = source.Where(x => x <= 5);

// クエリ構文
// クエリ構文ではselectを省略不可
var queryResult =
    from x in source
    where x <= 5
    select x;

またクエリ構文で記述したコードはコンパイルを通して標準クエリ演算子に変換されますので、最終的に得られる結果は同一になります。
前述のコードから得られる実行形式のファイルを逆コンパイルした結果は下記となります。

// Program
using System.Collections.Generic;
using System.Linq;

private static void <Main>$(string[] args)
{
	int[] source = new int[9] { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
	IEnumerable<int> methodResult = source.Where((int x) => x <= 5);
	IEnumerable<int> queryResult = source.Where((int x) => x <= 5);
}

なお全ての標準クエリ演算子をクエリ構文で記述することはできないため、それらの機能が必要な場合はメソッド構文で記述する必要があります。
※メソッド構文とクエリ構文を混ぜて使用することも可能ですが、式を分けるかどちらかに統一したほうが可読性の面からも無難です。

基本的な使い方

Where によるデータの抽出と Select によるデータの選択・処理

Where メソッドでは、コレクションから条件に合致する要素を抽出することが可能です。
Select メソッドでは、コレクションの全要素に対して処理を行った結果を取得することができます。
Where メソッドと Select メソッドを組み合わせてコレクションの条件に合致した要素に処理を行った結果を取得する、といった用途で利用することが多いようです。
ここでは、数値のコレクションから条件に合致する要素を抽出し二乗したコレクションを取得する例を示します。

var source = new int[] { 1, 2, 3, 4, 5, 6, 7, 8, 9 };

// メソッド構文
var methodResult = source.Where(x => x <= 5).Select(x => x * x);

// クエリ構文
var queryResult =
    from x in source
    where x <= 5
    select x * x;

// 結果は { 1, 4, 9, 16, 25 } となる。

また、数値型のコレクションで利用する以外にも、オブジェクトのコレクションに対して処理を行うことも可能です。
例えば人物を定義するPersonクラスのコレクションから20歳以上の人を抽出して氏名をつなげた文字列を取得するといった処理の場合、下記のように書くことができます。
※本稿のサンプルコードではnullチェック等を行っていませんが、実際に利用する場合は例外が発生しないように条件式に気を付けましょう。

/// <summary>
/// 人物を定義するPersonクラス
/// </summary>
class Person
{
    /// <summary>名</summary>
    public string FirstName { get; set; }
    /// <summary>姓</summary>
    public string LastName { get; set; }
    /// <summary>年齢</summary>
    public int Age { get; set; }

    public Person(string firstName, string lastName, int age)
    {
        FirstName = firstName;
        LastName = lastName;
        Age = age;
    }
}

/// <summary>
/// サンプルクラス
/// </summary>
class Sample
{
    static void Main()
    {
        var persons = new[] {
            new Person("Terrance", "Huff", 18),
            new Person("Deven", "Cyrus", 26),
            new Person("Dave", "Corbett", 53),
            new Person("Brion", "Shoebridge", 12),
            new Person("Terence", "Long", 31)
        };

        // メソッド構文
        var methodResult = persons.Where(x => x.Age >= 20).Select(x => $"{x.FirstName} {x.LastName}");

        // クエリ構文
        var queryResult =
            from x in persons
            where x.Age >= 20
            select $"{x.FirstName} {x.LastName}";

        // 結果は { "Deven Cyrus", "Dave Corbett", "Terence Long" } となる。
    }
}

GroupBy によるデータの組み分け

GroupBy メソッドでは、コレクションの要素から取得した値をもとにグルーピングを行い、グループごとにデータを抽出することが可能です。
下記のサンプルコードでは、前述のPersonクラスのコレクションを元にFirstNameの頭文字でグルーピングを行っています。

// メソッド構文
var methodResult = persons.GroupBy(x => x.FirstName[0], x => $"{x.FirstName} {x.LastName}");

// クエリ構文
var queryResult =
    from x in persons
    group $"{x.FirstName} {x.LastName}" by x.FirstName[0];

// 結果は、下記となる。
// Key 'T'
//   { "Terrance Huff", "Terence Long" }
// Key 'D'
//   { "Deven Cyrus", "Dave Corbett" }
// Key 'B'
//   { "Brion Shoebridge" }

OrderBy / OrderByDescending による並び替え

OrderBy メソッドは昇順、OrderByDescending メソッドは降順で、コレクションの要素の並び替えを行います。
クエリ構文の場合は orderby 句と ascending 句または descending 句の組み合わせで並び替える順序を指定します。
数値を降順で並び替える場合は、下記のようなコードになります。

var source = new int[] { 3, 5, 7, 1, 10, 8, 4, 6, 2, 9 };

// メソッド構文
var methodResult = source.OrderByDescending(x => x);

// クエリ構文
var queryResult =
    from x in source
    orderby x descending
    select x;

// 結果は { 10, 9, 8, 7, 6, 5, 4, 3, 2, 1 } となる。

最後に

今回は割と利用頻度が高いと思われるメソッドを簡単に説明しましたが、これらを組み合わせることで複雑なデータの抽出処理を可読性を上げつつ簡単に記述することができます。
ただし LINQ は気軽に使える反面、書き方によっては非常に大量のメモリを使うことがあるため、Web アプリケーションのように複数スレッドで同時実行されるようなプログラムで大量のデータを扱う場合は、問題がないか十分気を付ける必要があります。
適切な場所でうまく活用できるようにしましょう。